Daten & Technologie
„Headless CDP“ ist ein Scheinbegriff: Worauf es bei Kundendaten in Banken wirklich ankommt
CDPs waren immer „headless“. Was zählt, ist der Data Layer: Ereignisschema, Identitätsauflösung, Einwilligung, Echtzeit. Sieben Prüffragen für Banken.
•
acceleraid Redaktion
8 Min. Lesezeit
Wer 2026 eine Customer Data Platform (CDP, Plattform zur Zusammenführung von Kundendaten) für eine Bank auswählt, begegnet einem neuen Etikett: „headless“. Der Begriff klingt nach Architekturfortschritt, nach einer Plattform ohne Oberfläche, die sich sauber in jede Landschaft einfügt. Bei genauer Betrachtung beschreibt er allerdings etwas, das CDPs per Definition immer waren. Die relevante Frage für Banken lautet nicht, ob eine Plattform „headless“ ist, sondern wie belastbar ihr Data Layer (Datenschicht) ist: das Ereignisschema, die Identitätsauflösung, die Einwilligungsverwaltung und die Aktivierung in Echtzeit. Dieser Beitrag ordnet den Begriff ein und leitet daraus Prüfkriterien ab, die im Auswahlprozess tatsächlich Unterschiede sichtbar machen.
Woher der Begriff kommt
„Headless“ stammt aus der Welt der Content-Management-Systeme (CMS, Systeme zur Verwaltung von Webinhalten). Dort trennt ein Headless CMS die Verwaltung der Inhalte von ihrer Darstellung und stellt sie über eine API (Application Programming Interface, Programmierschnittstelle) bereit. Auf Kundendaten wurde die Idee erstmals 2022 übertragen, als RudderStack eine „headless customer data platform“ als Bindegewebe zwischen dem Cloud-Data-Warehouse und den Kanälen beschrieb. Schon damals hielt die Fachseite Stacktonic fest, dass es „keine exakte Definition gibt und wahrscheinlich nie geben wird“.
Die Marktforschung hat sich seither andere Begriffe für dieselbe Idee zugelegt. Der Begriff „Composable CDP“ wurde laut CDP.com um 2020 von Hightouch und Census populär gemacht; das CDP Institute definiert ihn als „eine Architektur, in der Kundenprofile im Enterprise Data Warehouse des Unternehmens aufgebaut werden statt in einer separaten CDP-Datenbank“. „Warehouse-native“, „Zero-Copy“ und „Headless“ beschreiben laut Datawhistl denselben architektonischen Kern: Die Kundendaten bleiben im Warehouse oder Lakehouse, Identität, Aktivierung und Orchestrierung setzen darauf auf. Zuletzt kam 2026 die Stufe „Agentic CDP“ hinzu, die CDP.com als „headless infrastructure for autonomous AI agents“ beschreibt, also als Infrastruktur, die Profile und Entscheidungen über MCP (Model Context Protocol, ein Standard für den Werkzeugzugriff von KI-Agenten), APIs und Kommandozeilen bereitstellt.
Vier Etiketten in sechs Jahren, jedes mit eigenem Vendor-Lager. Das ist ein Hinweis darauf, dass die Begriffe primär Positionierung leisten und nicht Unterscheidung.
Was eine CDP per Definition ist
Die Definition des CDP Institute lautet in ihrer Grundform seit Jahren: „packaged software that builds a persistent, unified customer database that is accessible to other systems“, also Software, die eine dauerhafte, vereinheitlichte Kundendatenbank aufbaut, die für andere Systeme zugänglich ist. Als typische Zugriffswege nennt das Institut „APIs, database queries, and file extracts“. In der aktualisierten Fassung für 2026 heißt es ausdrücklich, was eine CDP auszeichne, sei „nicht, wo diese Dienste ausgeführt werden, sondern dass die CDP das System ist, das für Kundenkontext, Konsistenz und die Nutzbarkeit in nachgelagerten Systemen verantwortlich ist“.
Die Zugänglichkeit für andere Systeme ist damit kein Zusatzmerkmal, sondern der Kern der Gattung. Eine CDP, die ihre Profile nicht per Schnittstelle bereitstellt, wäre keine CDP. Die Segment-Oberfläche, der Audience Builder oder das Dashboard sind Bedienhilfen, nicht das Produkt. Insofern beschreibt „headless“ eine Eigenschaft, die jedes ernstzunehmende Angebot seit 2013 hatte.
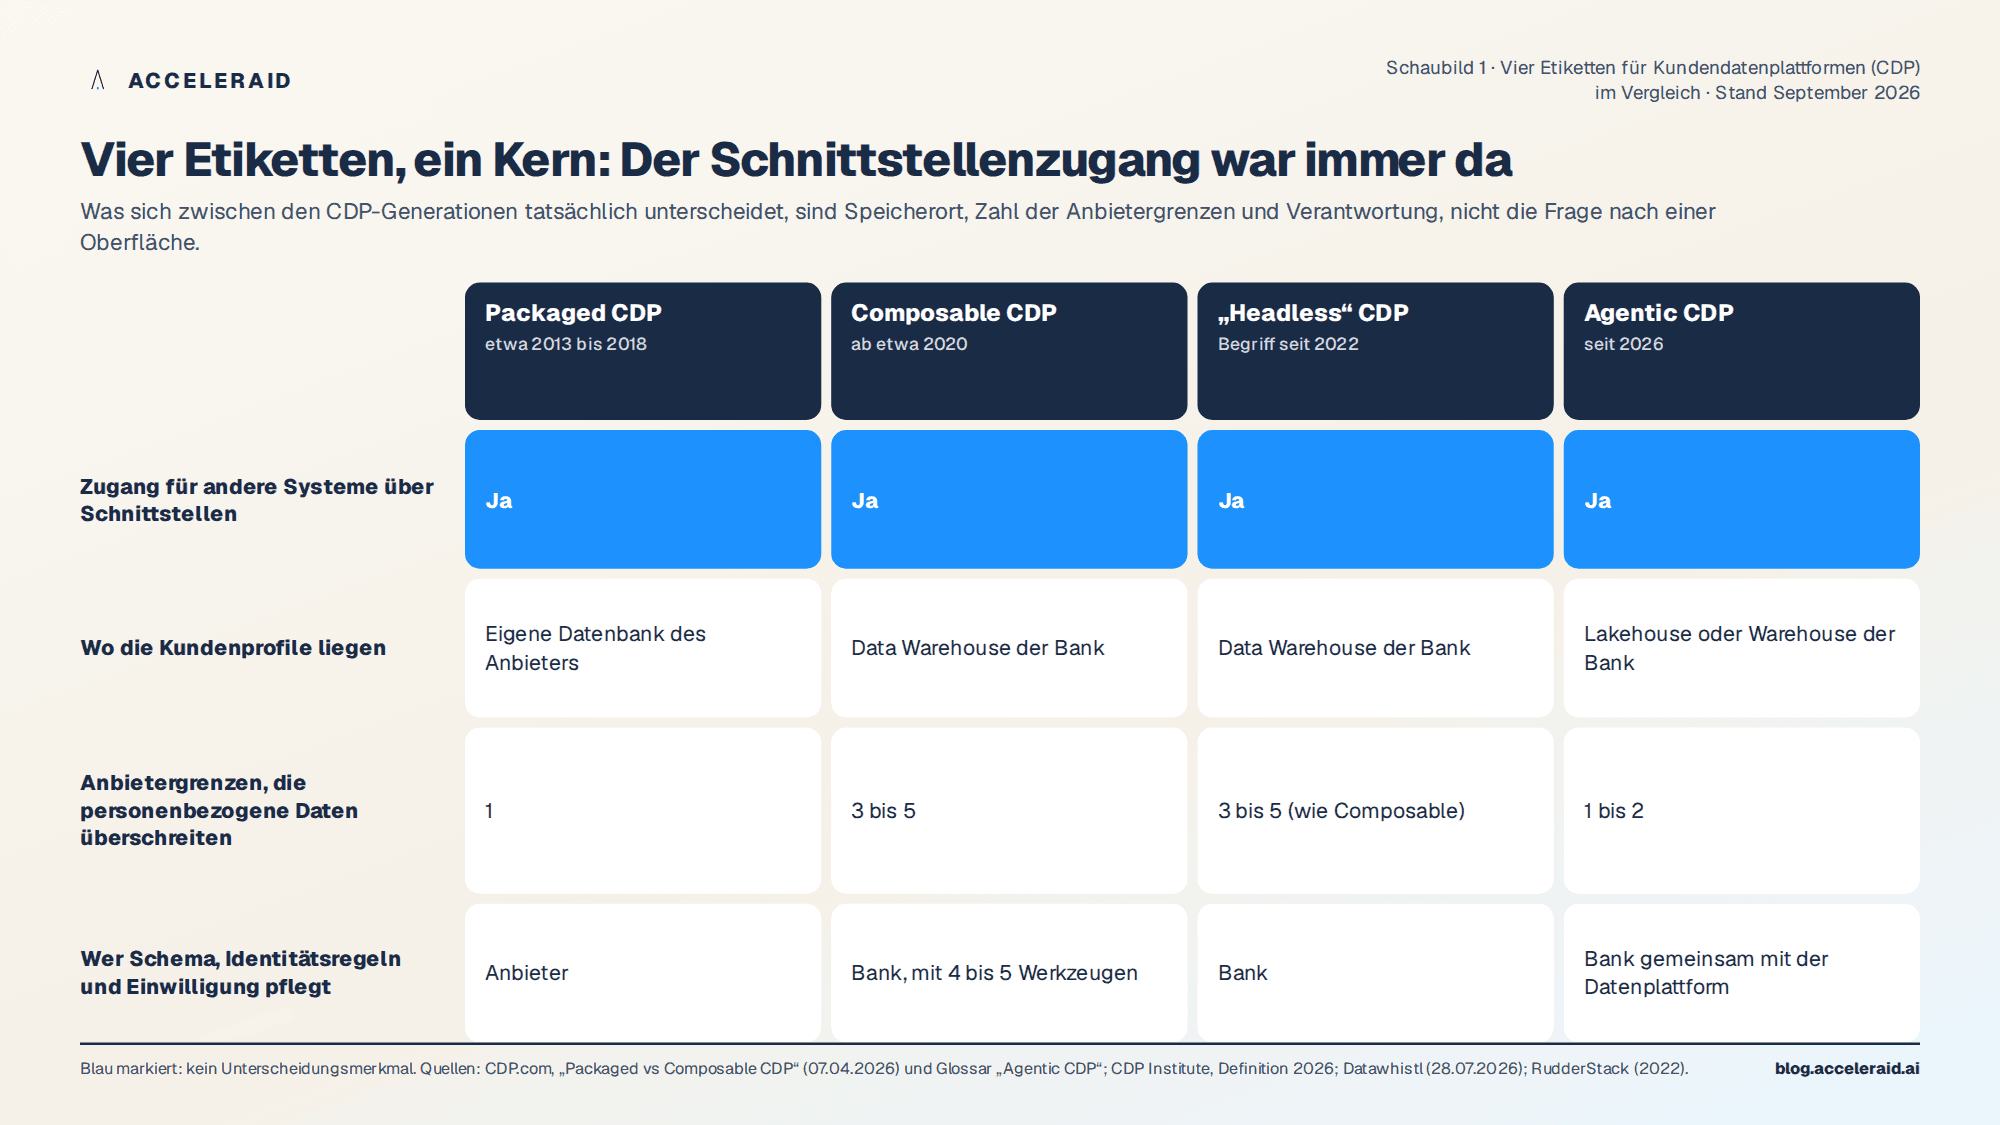
Was sich zwischen den Generationen wirklich unterscheidet, sind laut CDP.com andere Dinge: Erstgenerations-Plattformen (etwa 2013 bis 2018) arbeiteten mit Batch-Ingestion, proprietärem Speicher und regelbasierter Segmentierung; Composable-Stacks benötigen oft „4 bis 5 Werkzeuge“, und personenbezogene Daten (PII, Personally Identifiable Information) überschreiten dabei „3 bis 5“ Anbietergrenzen statt einer. Diese Größen entscheiden über Betriebskosten, Datenschutz und Auditierbarkeit. Ob es eine Oberfläche gibt, entscheidet über nichts davon.
Die vier Bausteine, die den Unterschied machen
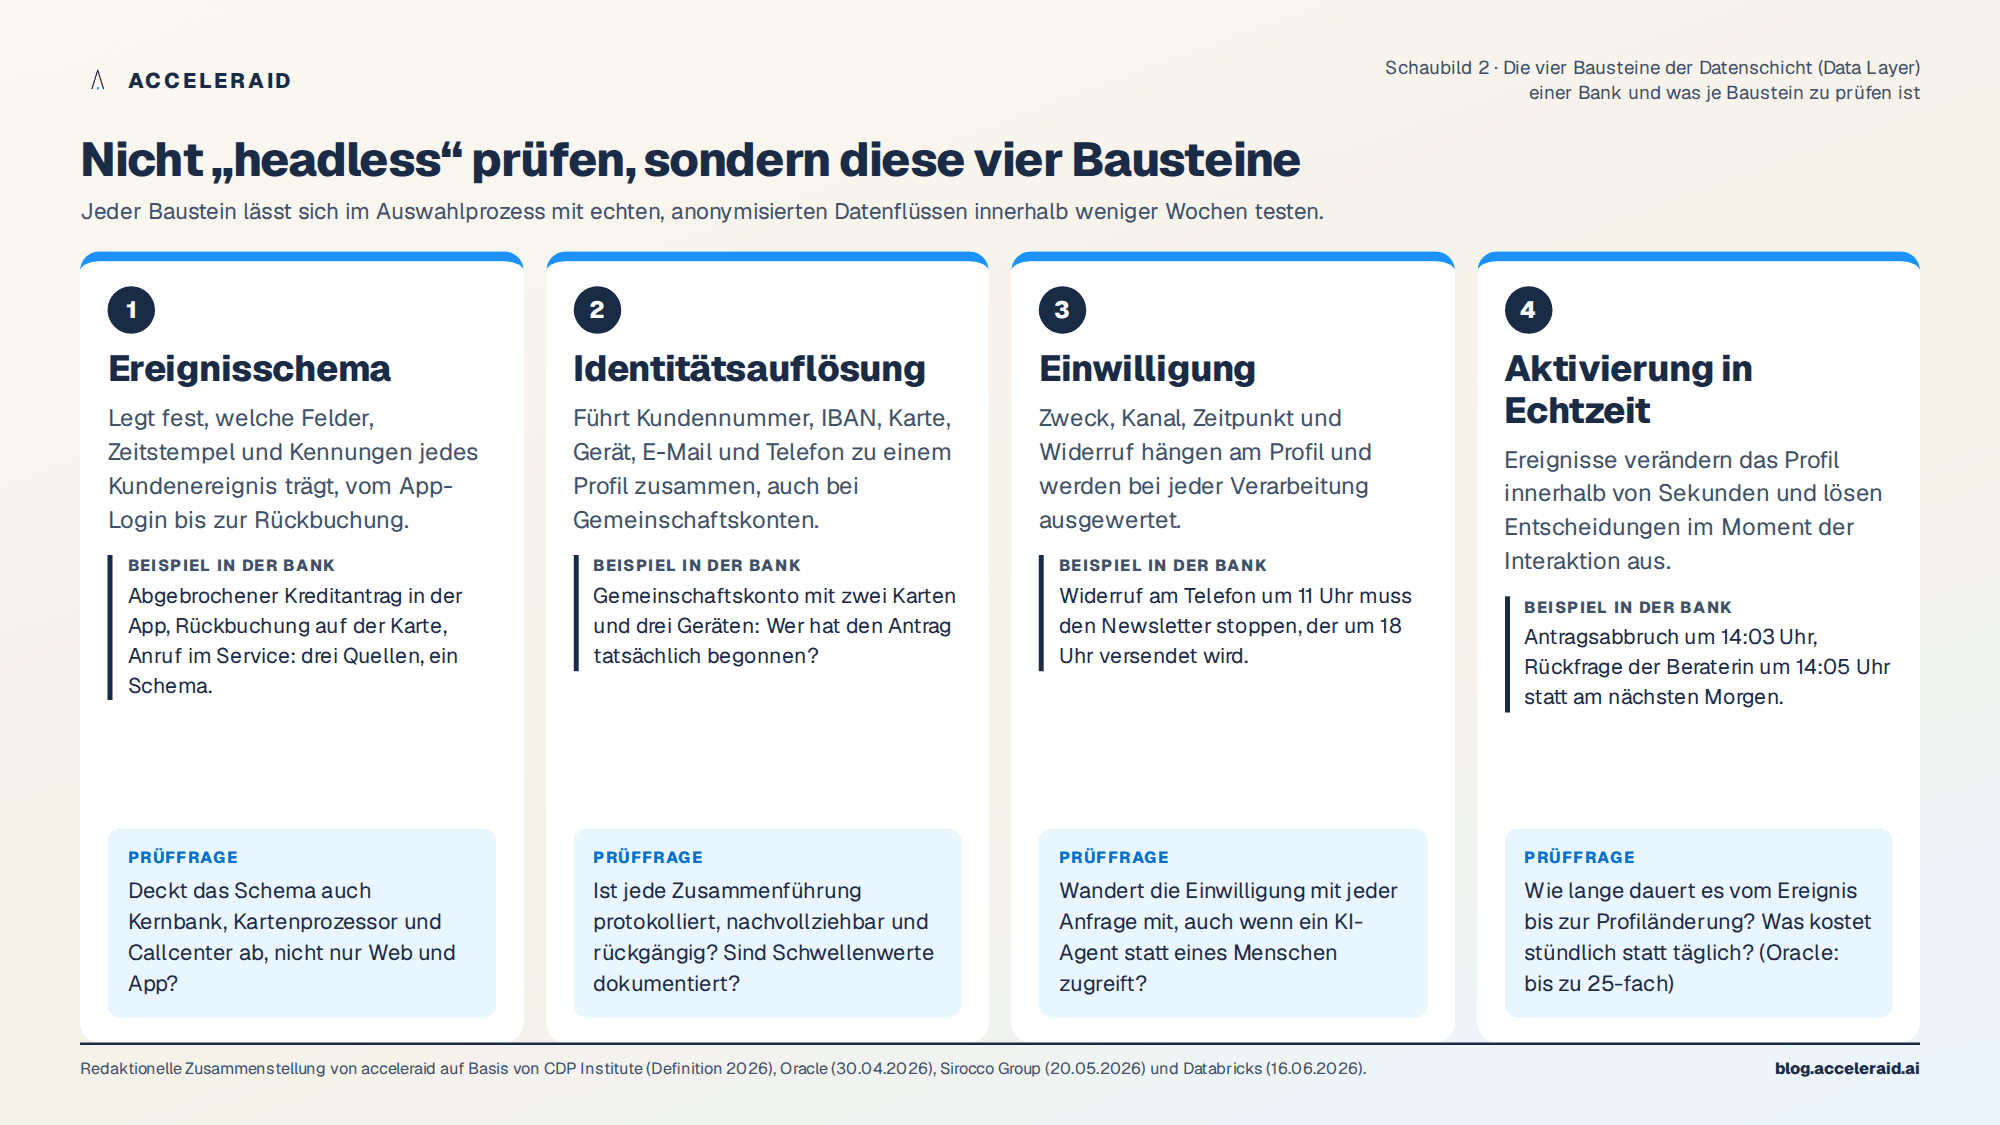
Wenn nicht die Oberfläche, was dann? Aus Sicht einer Bank zählt, ob die Datenschicht vier Aufgaben zuverlässig löst. Jede davon lässt sich im Auswahlprozess konkret prüfen.
1. Ereignisschema
Kundendaten entstehen als Ereignisse: eine Anmeldung in der App, ein abgebrochener Kreditantrag, eine Rückbuchung, ein Anruf im Service. Ohne ein gemeinsames Schema, das festlegt, welche Felder ein Ereignis trägt, welche Zeitstempel gelten und welche Kennungen mitgeführt werden, entsteht kein konsistentes Bild. Anbieter wie RudderStack werben mit „standardisierten Ereignissen aus jedem Kanal“ über Web-, Mobile- und Server-SDKs (Software Development Kits, Entwicklungsbibliotheken). Entscheidend ist für eine Bank jedoch, ob das Schema auch Ereignisse aus Kernbank, Kartenprozessor und Callcenter abbildet, die nie über ein Web-SDK laufen. Ein Schema, das nur digitale Berührungspunkte kennt, ist für eine Universalbank unvollständig.
2. Identitätsauflösung
Eine Person tritt in einer Bank unter vielen Kennungen auf: Kundennummer, IBAN, Kartennummer, App-Geräte-ID, E-Mail-Adresse, Telefonnummer, gegebenenfalls als Teil eines Gemeinschaftskontos oder eines Haushalts. Die Identitätsauflösung führt diese Kennungen zu einem Profil zusammen. Das CDP Institute weist der CDP ausdrücklich die „primäre Verantwortung für die Definition und Pflege der Kundenidentität“ zu. Bei Banken ist deterministisches Matching über geprüfte Kennungen die Regel; probabilistische Verfahren, die auf Wahrscheinlichkeiten beruhen, sind wegen der Folgen für Beratung, Betrugsprüfung und Kontaktregeln nur mit dokumentierten Schwellenwerten vertretbar. Wer heute „agentische Identitätsauflösung“ anbietet, wie Databricks es für CustomerLake beschreibt, muss erklären können, wie eine KI-gestützte Zusammenführung nachvollziehbar und rückgängig bleibt.
3. Einwilligung
Für eine Bank ist die Einwilligung kein Metadatum am Rand, sondern eine Bedingung für jede Aktivierung. Zweck, Kanal, Zeitpunkt und Widerruf müssen am Profil hängen und bei jeder Verarbeitung ausgewertet werden, unabhängig davon, ob ein Mensch, eine Kampagne oder ein KI-Agent zugreift. Genau hier liegt eine neue Herausforderung, auf die Sirocco zu Salesforce Headless 360 hinweist: Wenn Agenten ohne Oberfläche lesen, schreiben und Prozesse ausführen, müssen „Authentifizierung, Autorisierung und Einwilligung für nicht-menschliche Aufrufer“ geklärt sein. Die Einwilligung muss also mit der Anfrage durch die gesamte Kette wandern.
4. Aktivierung in Echtzeit
Ein Profil, das erst am nächsten Morgen aktualisiert ist, hilft bei einem abgebrochenen Antrag nicht mehr. Aktivierung in Echtzeit heißt, dass Ereignisse innerhalb von Sekunden das Profil verändern und Entscheidungen auslösen können. Hier zeigt sich der Preis von Zero-Copy-Architekturen. Oracle rechnet vor, dass der Wechsel von täglichen zu stündlichen Zielgruppen-Aktualisierungen die Rechenkosten im Warehouse „um das 25-Fache“ erhöhen kann und nahezu Echtzeit noch einmal „50 Prozent oder mehr“ kostet. Die Konsequenz aus dieser Sicht: Zero-Copy eignet sich für Referenz- und Analysedaten, Streaming für Verhaltensereignisse, und ein vorberechnetes, persistentes Profil für Identitätsauflösung, Scoring und sofortige Aktivierung.
Was sich 2026 tatsächlich verschiebt
Unabhängig vom Etikett ist 2026 ein Jahr, in dem sich der Ort der Kundendaten verschiebt. Am 16. Juni 2026 hat Databricks mit CustomerLake eine CDP direkt in das Lakehouse eingebaut, inklusive Identitätsauflösung, Segmentierung und Aktivierung; das Produkt befindet sich in der Private Preview. Salesforce hat im April 2026 mit Headless 360 zugesagt, „jedes Objekt, jeden Flow, jede Berechtigungsgrenze und jede Entscheidungsfähigkeit“ über APIs, MCP-Werkzeuge und Kommandozeilen zugänglich zu machen. Adobe und Salesforce federieren laut Datawhistl Zielgruppen gegen Snowflake, Databricks und BigQuery, ohne Datensätze zu importieren.
Damit stimmt ein Teil des Headless-Versprechens: Die Datenschicht wandert in die Datenplattform der Bank, und das Angebot der CDP-Anbieter verengt sich auf Identität, Aktivierung, Kanäle und Agentenzugriff. Für Banken ist das grundsätzlich attraktiv, weil Zugriffskontrollen, Verschlüsselung und Datenresidenz der eigenen Plattform automatisch gelten. Es verschiebt aber die Verantwortung: Das Ereignisschema, die Identitätsregeln und das Einwilligungsmodell werden dann von der Bank selbst gepflegt, nicht vom Anbieter. Ein Etikett ersetzt diese Arbeit nicht.
Was das für Banken konkret heißt
Drei Konsequenzen folgen daraus für den Auswahlprozess.
Erstens: Der Begriff „headless“ gehört nicht in die Anforderungsliste. Jede CDP ist per Definition über Schnittstellen zugänglich. In die Anforderungsliste gehören stattdessen die vier Bausteine mit messbaren Kriterien: Anzahl der Anbietergrenzen, die personenbezogene Daten überschreiten; Latenz vom Ereignis bis zur Profiländerung; Nachvollziehbarkeit jeder Zusammenführung; Durchreichung der Einwilligung an jeden Aufrufer.
Zweitens: Die Frage „Warehouse oder CDP“ ist falsch gestellt. Beide Systeme haben unterschiedliche Aufgaben. Das Warehouse hält die Historie und die analytische Wahrheit, die Aktivierungsschicht hält das operative Profil mit den Regeln, die im Moment der Interaktion gelten. Welche Daten kopiert werden und welche nicht, sollte pro Anwendungsfall entschieden werden. Oracle empfiehlt, die „fünf bis zehn Aktivierungsszenarien“ zu definieren, die wirklich zählen, und die Integrationsmethode daran auszurichten.
Drittens: Der Agentenzugriff verändert die Prüfkriterien, nicht die Architektur. Wenn ein KI-Agent im Service oder in der Beratung Kundendaten liest und Aktionen auslöst, muss die Datenschicht Rechte, Zweckbindung und Protokollierung für Maschinen genauso durchsetzen wie für Menschen. Sirocco rät, APIs und MCP-Server „unter realistischer Last“ zu testen und Ratenlimits, Latenz und Gleichzeitigkeit unter Agentenlast zu prüfen. Für eine Bank kommt hinzu, dass Agentenzugriffe auf Kundendaten in das Informationsregister nach DORA (Digital Operational Resilience Act, EU-Verordnung zur digitalen Betriebsstabilität) gehören.
Sieben Prüffragen für den Auswahlprozess
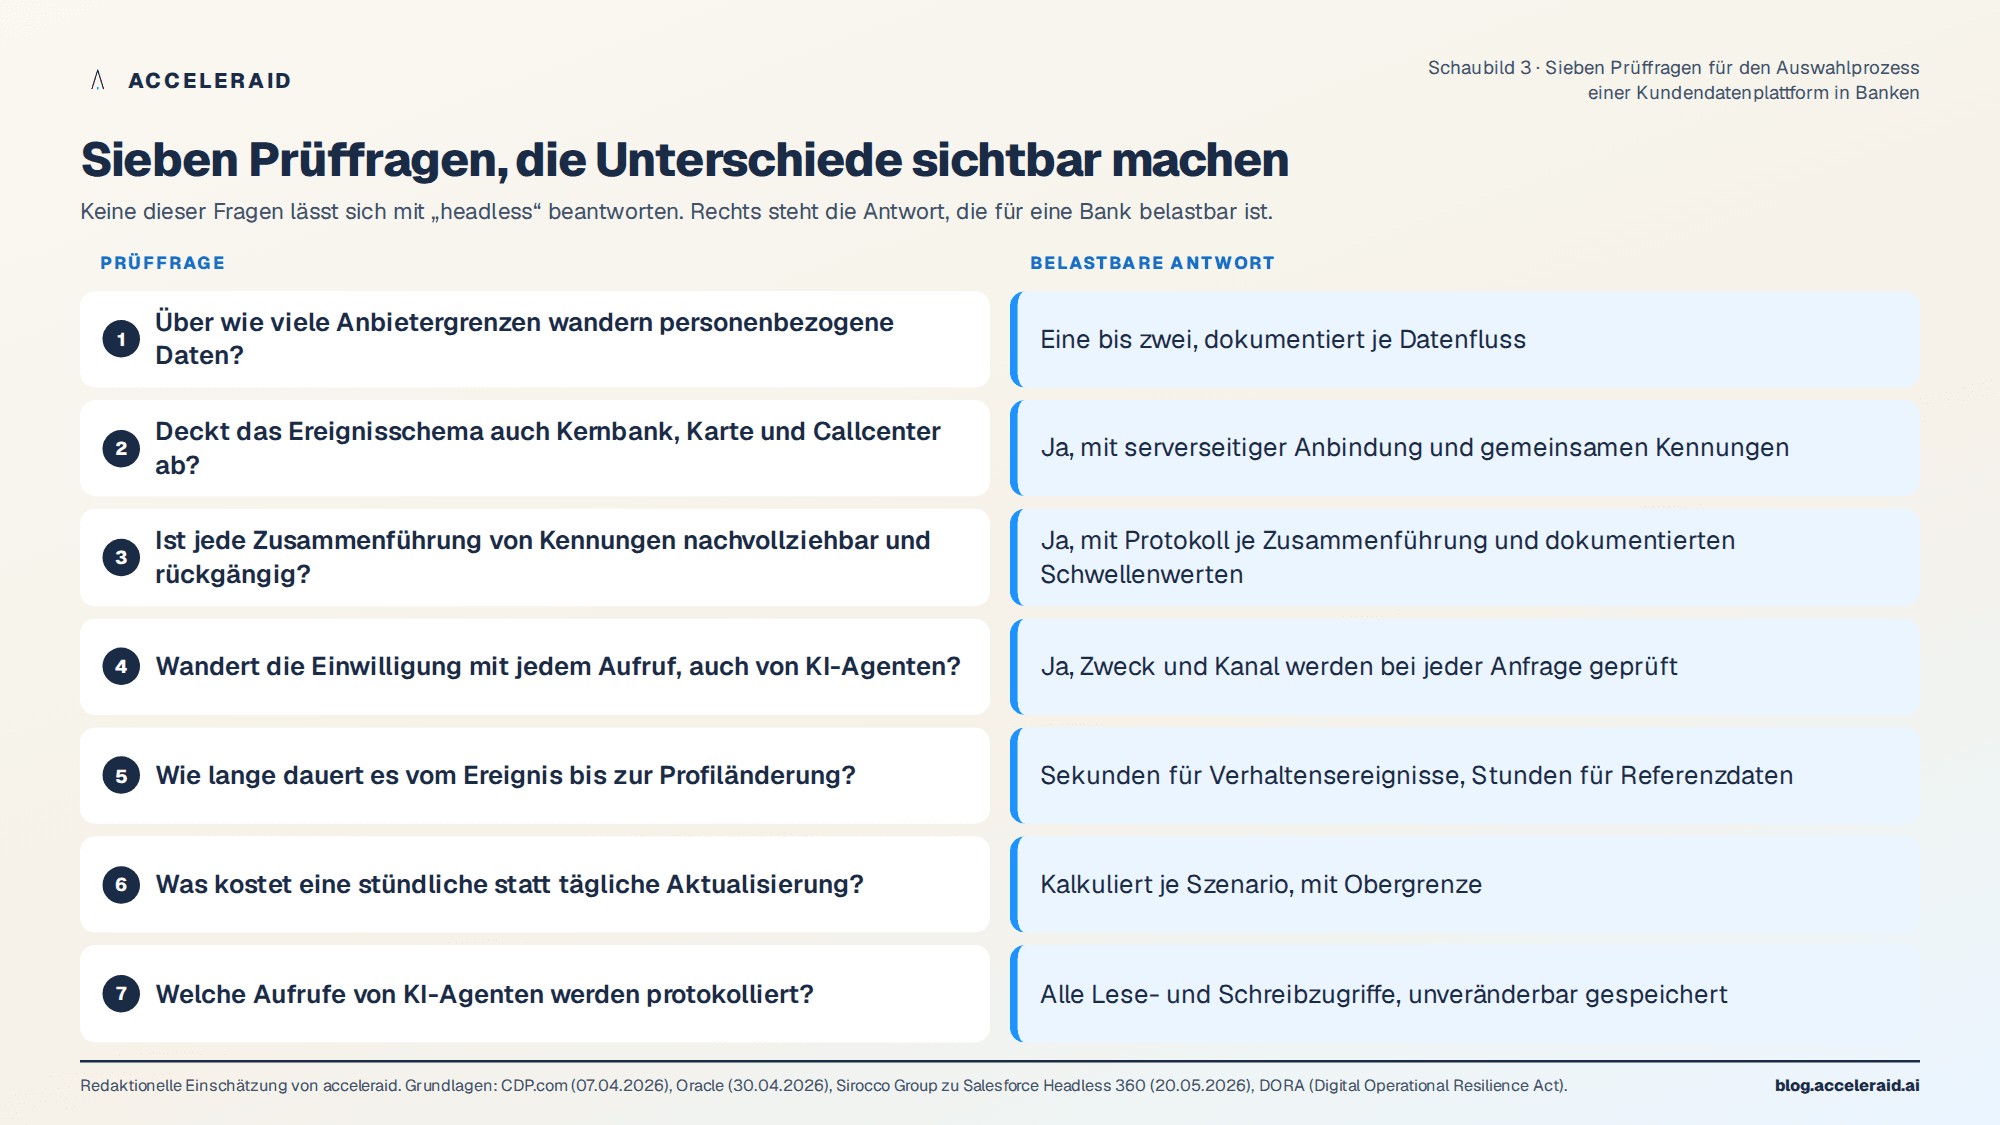
Die folgende Tabelle fasst zusammen, welche Fragen im Auswahlprozess Unterschiede sichtbar machen und welche Antwort für eine Bank belastbar ist.
Prüffrage | Belastbare Antwort |
|---|---|
Über wie viele Anbietergrenzen wandern personenbezogene Daten? | Eine bis zwei, dokumentiert je Datenfluss |
Deckt das Ereignisschema auch Kernbank, Karte und Callcenter ab? | Ja, mit Server-seitiger Anbindung und gemeinsamen Kennungen |
Ist jede Zusammenführung von Kennungen nachvollziehbar und rückgängig? | Ja, mit Protokoll je Match und dokumentierten Schwellenwerten |
Wandert die Einwilligung mit jedem Aufruf, auch von Agenten? | Ja, Zweck und Kanal werden bei jeder Anfrage geprüft |
Wie lange dauert es vom Ereignis bis zur Profiländerung? | Sekunden für Verhaltensereignisse, Stunden für Referenzdaten |
Was kostet eine stündliche statt tägliche Aktualisierung? | Kalkuliert je Szenario, mit Obergrenze |
Welche Aufrufe von Agenten werden protokolliert? | Alle Lese- und Schreibzugriffe, unveränderbar gespeichert |
Keine dieser Fragen lässt sich mit „headless“ beantworten. Alle lassen sich in einem Proof of Concept (Machbarkeitsnachweis) mit echten, anonymisierten Datenflüssen innerhalb weniger Wochen prüfen.
Fünf Punkte zum Mitnehmen
„Headless“ beschreibt eine Eigenschaft, die CDPs per Definition seit ihrer Entstehung haben: Zugänglichkeit für andere Systeme über Schnittstellen. Als Auswahlkriterium hat der Begriff keinen Unterscheidungswert.
Unterschiede zwischen Plattformen liegen im Data Layer: Ereignisschema, Identitätsauflösung, Einwilligungsverwaltung und Aktivierung in Echtzeit. Diese vier Bausteine sind prüfbar.
Zero-Copy und Warehouse-native Architekturen verschieben die Datenschicht in die Bankplattform und damit die Verantwortung für Schema, Identitätsregeln und Einwilligungsmodell auf die Bank.
Echtzeit hat einen Preis: Stündliche Aktualisierungen im Warehouse können laut Oracle die Rechenkosten um das 25-Fache erhöhen. Welche Daten kopiert werden, sollte pro Anwendungsfall entschieden werden.
Der Zugriff durch KI-Agenten verändert die Prüfkriterien: Rechte, Zweckbindung, Protokollierung und Lasttests müssen für Maschinen genauso gelten wie für Menschen, inklusive Erfassung im DORA-Register.
Acceleraid arbeitet in Kundenprojekten auf den vorhandenen Datenplattformen der Banken und verbindet Identität, Einwilligung und Aktivierung mit den Entscheidungsregeln des Customer Lifecycle Management (Steuerung des Kundenlebenszyklus). Welche Bausteine dafür in einer konkreten Landschaft fehlen, lässt sich mit den sieben Prüffragen in kurzer Zeit klären.
Illustration: KI-generiert. KI-gestützte Inhalte: Bei der Erstellung unserer Beiträge setzen wir KI-Technologien und automatisierte Agenten ein, unter anderem von Microsoft, Google, OpenAI, Anthropic und weiteren Anbietern. Themen, fachliche Ausrichtung und finale Freigabe liegen bei unserem Team.
